Mach diesen Test. Finde jetzt sofort diese drei Dinge heraus. Ohne jemanden zu fragen:
Den aktuellen Status deiner fünf größten Projekte. Die kompletten Kontaktdaten und Vertragsbedingungen deiner zehn wichtigsten Kunden. Und die genaue Umsatzverteilung nach Leistungsbereich für das letzte Quartal.
Wenn du alle drei in unter zehn Minuten findest. An einem einzigen Ort. Ohne einen einzigen Anruf. Dann sind deine Daten in einem besseren Zustand als bei den meisten Unternehmen, mit denen wir arbeiten. Hat es länger gedauert? Musstest du vier verschiedene Tools öffnen, deine E-Mails durchsuchen und jemanden fragen, der „weiß, wo diese Datei liegt“? Dann hast du ein Datenproblem. Kein Technologieproblem. Ein Datenproblem.
Eine Studie von DATAVERSITY aus 2026 zeigt: Für 68 % der Unternehmen sind Datensilos das größte operative Problem. Laut dem Connectivity Benchmark Report 2025 von MuleSoft nutzen Organisationen durchschnittlich 897 Anwendungen, aber nur 29 % sind miteinander verknüpft. Die restlichen 71 % arbeiten als isolierte Informationsinseln.
Für ein mittelständisches Dienstleistungsunternehmen ist die Anzahl der Anwendungen kleiner. Das Muster ist aber genau dasselbe: Kundendaten im CRM. Projektdaten in Excel. Finanzdaten in der Buchhaltung. Kommunikation via E-Mail und WhatsApp. Dokumente auf einem Netzlaufwerk, dem niemand vertraut. Und das Firmenwissen in den Köpfen der Leute.
Das Resultat ist nicht nur Ineffizienz. Es sind unzuverlässige Entscheidungen. Wenn der Geschäftsführer kein klares Bild des Unternehmens sieht, ohne einen halben Tag lang Daten aus sechs Quellen zusammenzutragen, wird aus dem Bauch heraus entschieden. Nicht, weil der Geschäftsführer das Bauchgefühl bevorzugt. Sondern weil die Alternative einfach zu lange dauert.

Wenn der Geschäftsführer kein klares Bild seines Unternehmens sieht, ohne einen halben Tag lang Daten aus sechs Quellen zusammenzutragen, wird aus dem Bauch heraus entschieden. Nicht, weil der Geschäftsführer das Bauchgefühl bevorzugt. Sondern weil die Alternative einfach zu lange dauert.

Dieser Leitfaden gibt dir eine einfache Übung an die Hand: Du kartierst, wo deine Daten tatsächlich liegen, siehst sofort, wo Informationen doppelt vorkommen oder fehlen, und identifizierst den ersten Schritt zur Besserung.
Was ist eine Single Source of Truth und warum braucht dein Unternehmen eine?
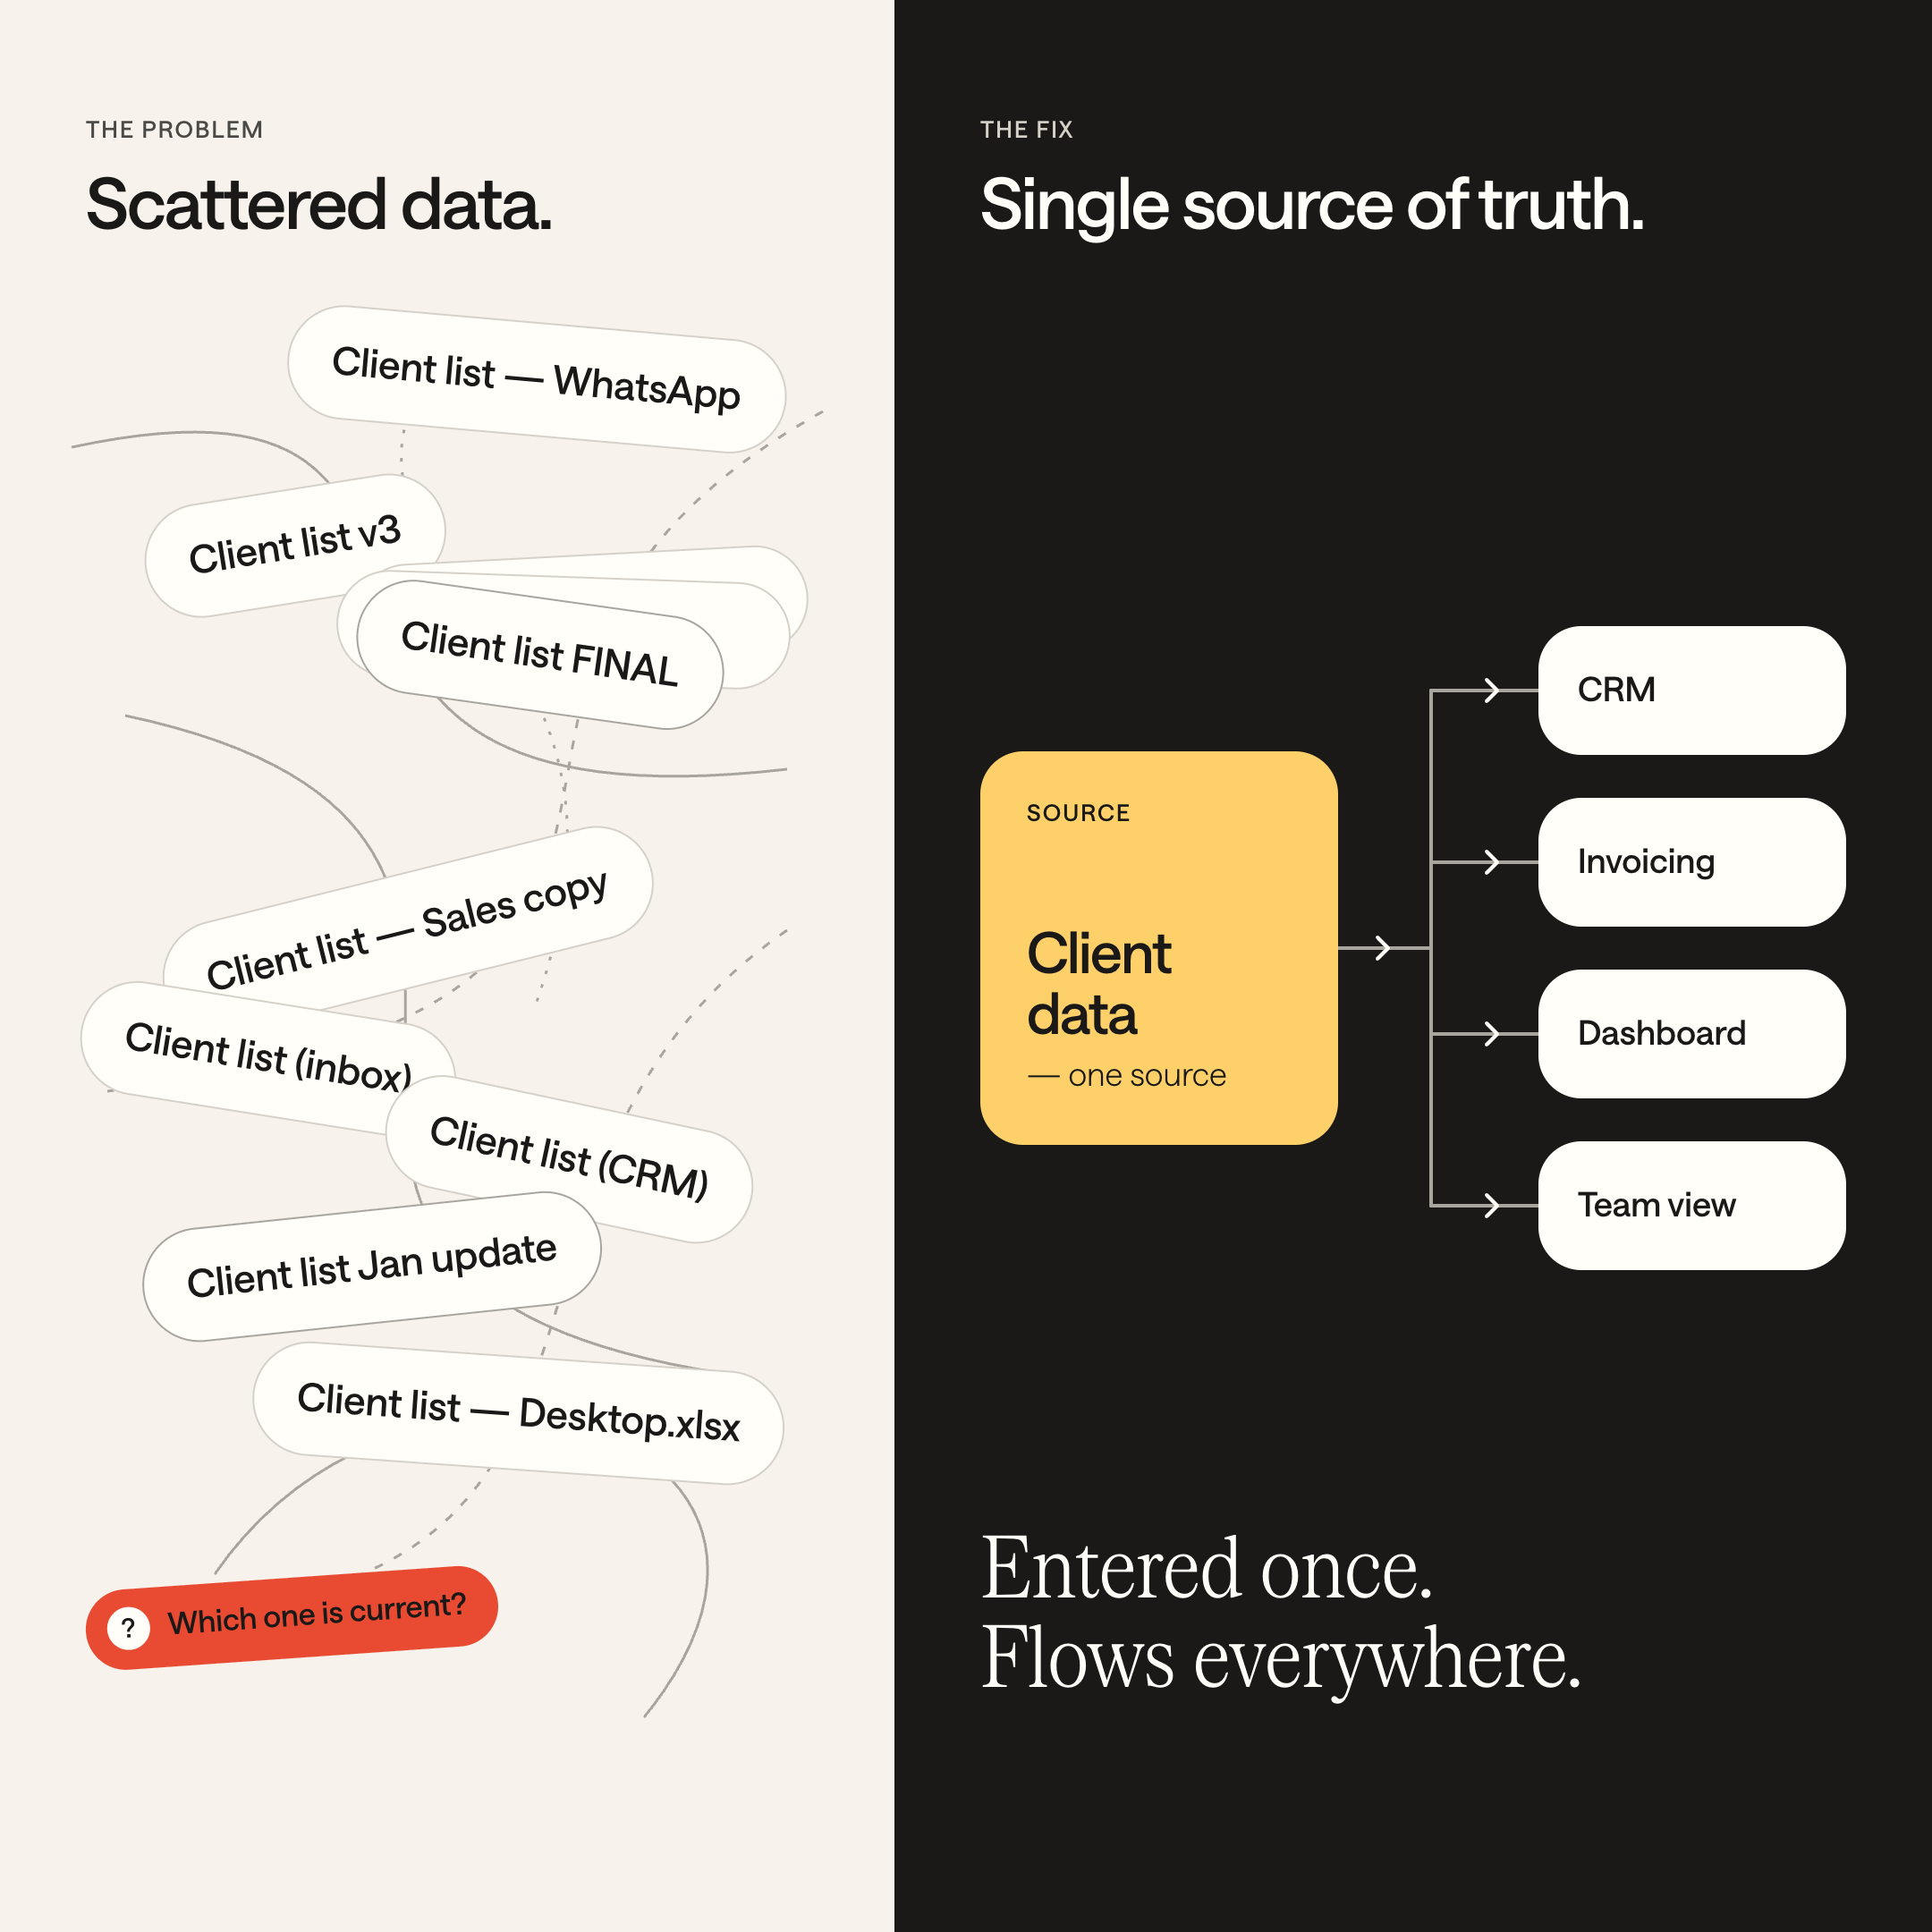
Die kwapso-Definition: Single Source of Truth. Für jede Art von Information in deinem Unternehmen gibt es genau einen Ort, an dem die korrekte, aktuelle Version liegt. Nicht drei Excel-Listen mit leicht unterschiedlichen Zahlen. Nicht eine E-Mail von letzter Woche. Ein Ort. Eine Wahrheit. Wenn dieselbe Information woanders benötigt wird, fließt sie automatisch aus dieser Quelle. Sie wird niemals manuell neu erfasst oder kopiert.
Das ist kein Technologie-Konzept. Es ist ein organisatorisches Prinzip. Eine Single Source of Truth kann eine gut gepflegte Excel-Tabelle sein, sofern sie der einzige Ort ist, an dem diese Daten leben, und jeder im Team das weiß. Das Problem ist nicht das Format. Das Problem entsteht, wenn dieselben Daten an fünf verschiedenen Orten existieren, niemand weiß, welche Version aktuell ist, und jede Änderung von jemandem manuell an allen fünf Stellen nachgezogen werden muss.
Der MuleSoft 2025 Connectivity Benchmark Report zeigt, dass 80 % der Unternehmen Datensilos als größtes Hindernis für ihre Automatisierungs- und KI-Ziele nennen. Zudem kosten Integrationsprobleme Unternehmen durchschnittlich 6,8 Millionen US-Dollar pro Jahr an verlorener Produktivität und verzögerten Projekten. Für ein mittelständisches Unternehmen ist der Betrag proportional kleiner, aber der Effekt ist exakt derselbe: Zeitverschwendung beim Suchen, Fehler durch veraltete Stände und Entscheidungen auf Basis unvollständiger Informationen.
Du hast beim Betriebs-Check im Bereich Daten & Informationen niedrig abgeschnitten? Dann ist dieser Leitfaden dein nächster Schritt. 30 Fragen: Läuft dein Betrieb durch Willenskraft oder Struktur?
Wie verschaffe ich mir einen Überblick darüber, wo die Daten meines Unternehmens liegen?
Das ist die Übung. Sie dauert etwa eine Stunde. Du brauchst einen Stift und die Bereitschaft, ehrlich zu sein, wie chaotisch die Lage wirklich ist.
Schritt 1: Priorisiere deine Datenkategorien
Richte den Blick auf die Arten von Informationen, von denen dein Unternehmen abhängt. Jedes Unternehmen ist anders, aber diese Kategorien decken die meisten Dienstleistungsbetriebe ab:
Kunden- und Kontaktdaten. Projekt- oder Auftragsdaten. Finanzunterlagen (Rechnungen, Angebote, Ausgaben). Mitarbeiter- und Personalunterlagen. Lieferanteninformationen. Verträge und Vereinbarungen. Termin- und Kalenderdaten. Interne Kommunikation und Entscheidungen. Produkt- oder Leistungsspezifikationen. Reporting und KPIs.
Falls du branchenspezifische Zusatzkategorien hast, ergänze sie einfach.
Schritt 2: Notiere für jede Kategorie alle Orte, an denen diese Daten existieren
Geh gründlich vor. An diesem Punkt sind die meisten Geschäftsführer überrascht. Berücksichtige:
Software-Tools (CRM, Buchhaltung, Projektmanagement, Terminplanung). Excel-Listen und Google Sheets (auf dem Desktop von jemandem). E-Mail-Postfächer (wo Verträge, Freigaben und Entscheidungen oft dauerhaft liegen). Chat-Plattformen (WhatsApp-Gruppen, Teams-Kanäle, wo Infos geteilt, aber nie strukturiert abgelegt werden). Netzlaufwerke und Cloud-Speicher (Google Drive, Dropbox, OneDrive, der Server im Hinterzimmer). Physische Dokumente (der Aktenschrank, der Ordner im Regal, der Stapel Papier auf dem Schreibtisch). Die Köpfe der Mitarbeiter (Wissen, das nirgendwo sonst existiert).
Schritt 3: Markiere die primäre Quelle
Frage dich für jede Datenkategorie: Welche dieser Stellen ist die verbindliche Version? Diejenige, die das Team nutzen soll? Diejenige, die zuerst aktualisiert wird?
Kannst du pro Kategorie klar eine primäre Quelle benennen, hast du den Anfang einer Datenarchitektur. Kannst du das nicht oder würden verschiedene Mitarbeiter unterschiedliche Antworten geben, hast du das Problem bereits gefunden.
Schritt 4: Zähle die Duplikate
Zähle für jede Kategorie, an wie vielen Orten die Daten existieren. Ein Ort ist ideal. Zwei Orte sind überschaubar, wenn einer davon eindeutig die Quelle ist. Drei oder mehr Orte bedeuten, dass jemand in deinem Team jede Woche Zeit damit verbringt, mehrere Versionen synchron zu halten – und wahrscheinlich daran scheitert.
Hier ist eine vereinfachte Matrix für deine Bestandsaufnahme:
Kundenkontakte
Wo liegen die Daten?
Primäre Quelle definiert?
Anzahl der Kopien
Projektstatus
Wo liegen die Daten?
Primäre Quelle definiert?
Anzahl der Kopien
Rechnungsstellung / Finanzen
Wo liegen die Daten?
Primäre Quelle definiert?
Anzahl der Kopien
Mitarbeiterdaten
Wo liegen die Daten?
Primäre Quelle definiert?
Anzahl der Kopien
Lieferanteninfos
Wo liegen die Daten?
Primäre Quelle definiert?
Anzahl der Kopien
Verträge
Wo liegen die Daten?
Primäre Quelle definiert?
Anzahl der Kopien
Terminplanung
Wo liegen die Daten?
Primäre Quelle definiert?
Anzahl der Kopien
Entscheidungen / Freigaben
Wo liegen die Daten?
Primäre Quelle definiert?
Anzahl der Kopien
KPIs / Reporting
Wo liegen die Daten?
Primäre Quelle definiert?
Anzahl der Kopien
Dein nächster Schritt
Sobald du die Matrix ausgefüllt hast, wähle genau eine Kategorie mit mehr als zwei Kopien aus und definiere dafür deine verbindliche Single Source of Truth. Mach diesen ersten Schritt zur Regel für das gesamte Team, bevor du das nächste System anfasst.
Nach welchen Mustern solltest du suchen?
Nach dem Ausfüllen deiner Bestandsaufnahme zeichnen sich typischerweise drei Muster ab.
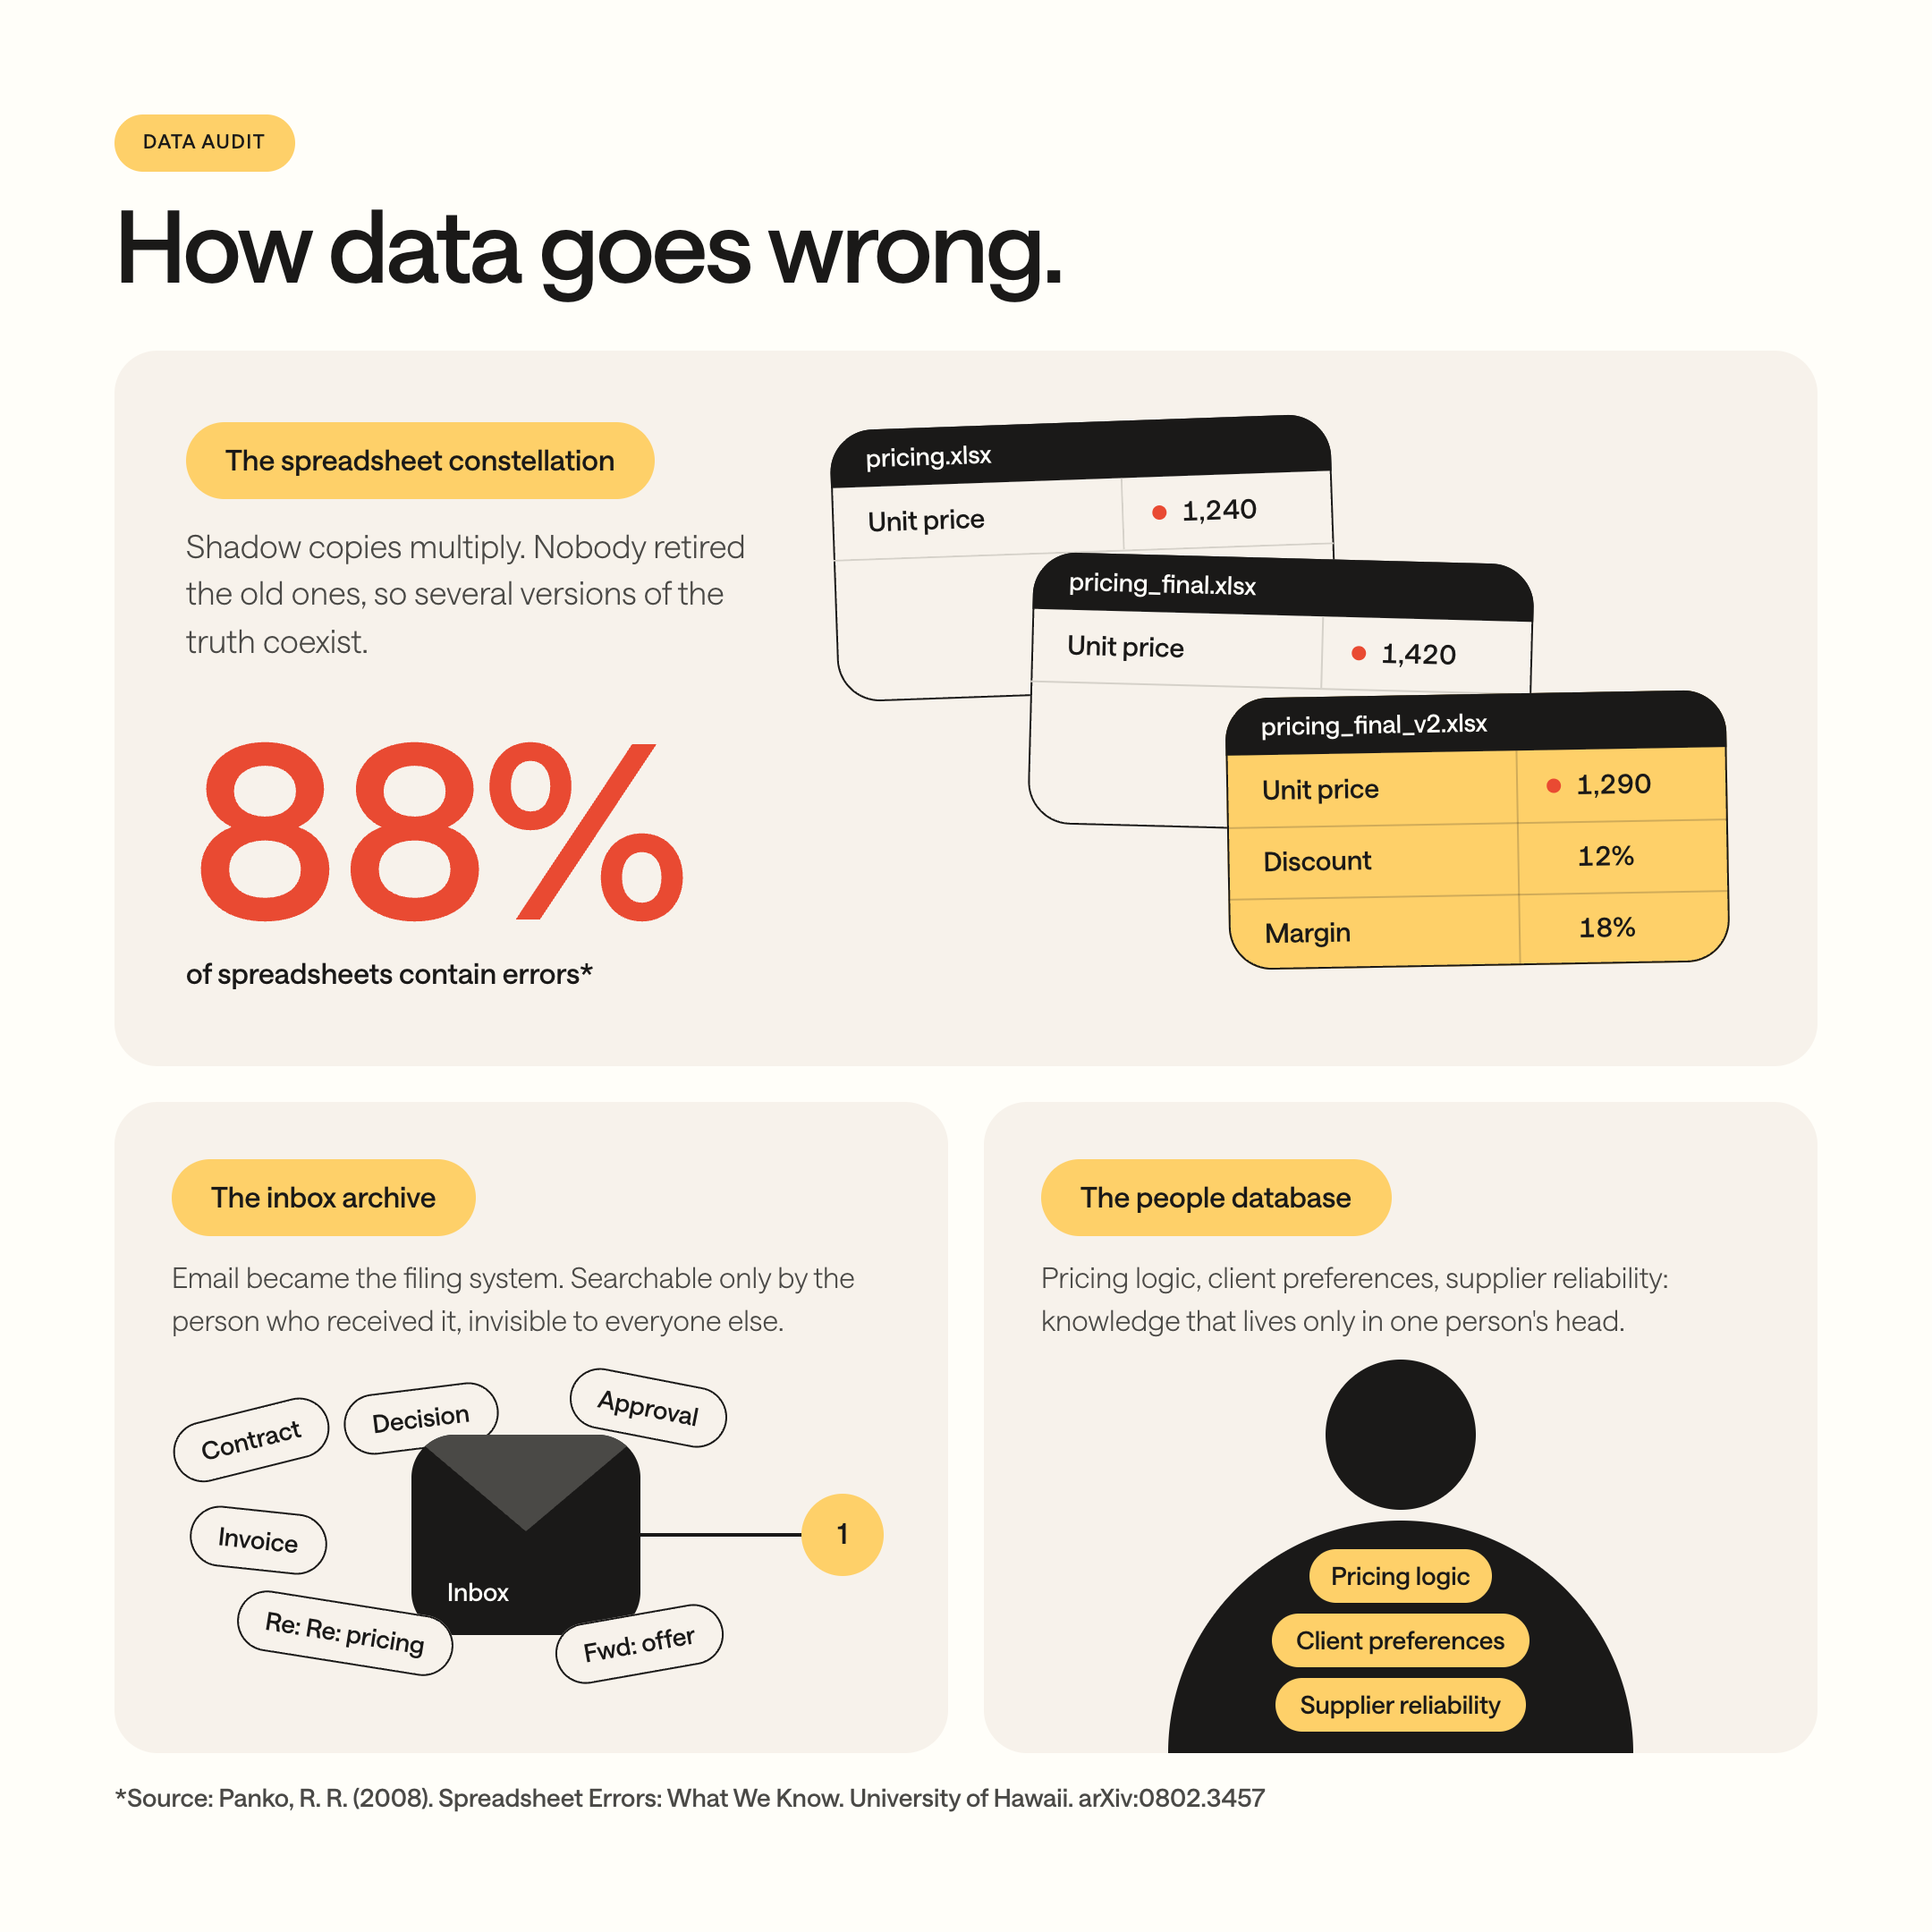
Das Excel-Konstrukt
Das mit Abstand häufigste Muster: Kundendaten liegen im CRM, aber gleichzeitig in einer separaten Excel-Liste, die das Vertriebsteam führt. Projektdaten stehen im Projektmanagement-Tool, aber ebenso in einer geteilten Tabelle, die der Geschäftsführer wöchentlich prüft. Die Finanzübersicht findet sich in der Buchhaltungssoftware, aber auch in einem maßgeschneiderten Excel-Bericht, den vor vier Jahren jemand gebaut hat.
Jede dieser Tabellen entstand, um ein konkretes Problem zu lösen: Jemand brauchte Informationen in einem Format, das das Haupt-Tool nicht lieferte. Das Problem ist nicht die Tabelle an sich. Das Problem ist, dass niemand sie ausgemustert hat, als sich der Bedarf änderte. Jetzt existieren mehrere Versionen der Wahrheit nebeneinander.
Eine Studie der University of Hawaii zeigt, dass 88 % aller geschäftlich genutzten Excel-Tabellen Fehler enthalten. Wenn solche Tabellen als Schattenkopien von Daten dienen, die auch woanders liegen, vervielfacht sich diese Fehlerquote. Das Team trifft Entscheidungen auf Basis einer Zahl in der Excel-Tabelle, die nicht mit der Zahl im Buchhaltungssystem übereinstimmt – und niemand weiß, welche davon stimmt.
Das E-Mail-Archiv
E-Mail ist ein Kommunikationswerkzeug. In den meisten Unternehmen ist es jedoch auch zum Ablagesystem, zum Entscheidungsprotokoll, zum Vertragsarchiv und zum Freigabe-Nachweis geworden. Wenn jemand fragt: „Haben wir diesen Bedingungen zugestimmt?“, lautet die Antwort: „Schau in deinen E-Mails nach.“ Fehlt der unterzeichnete Vertrag, heißt es: „Der müsste im Posteingang von jemandem liegen.“
Das Problem dabei: E-Mails kann nur die Person durchsuchen, die sie empfangen hat. Für alle anderen sind sie unsichtbar. Verlässt diese Person das Unternehmen oder kommt jemand neu ins Team, sind die Informationen praktisch verloren. E-Mail ist ein Kommunikationskanal, keine Datenarchitektur. Jede Information, die nur in einem Posteingang liegt, ist eine Information, auf die das Unternehmen nicht verlässlich zugreifen kann.
Die Personendatenbank
Muster Nummer drei führt direkt zu Wissenssilos. Bestimmte Informationen existieren ausschließlich in den Köpfen einzelner Mitarbeiter: die Logik hinter der Preisgestaltung, Vorlieben von Kunden, die Verlässlichkeit von Lieferanten oder der eigentliche Grund, warum ein Ablauf genau so funktioniert, wie er funktioniert. Das Team sucht nicht nach diesen Informationen. Es fragt einfach die jeweilige Person. Und weil diese Person immer antwortet, bemerkt niemand die Abhängigkeit – bis die Person ausfällt.
In einem mittelständischen Unternehmen ohne eigenes Datenteam verschwindet dieser Aufwand nicht einfach. Er fällt auf diejenigen zurück, die „wissen, wo die Dinge liegen“ – meist die langjährigsten Mitarbeiter. Die Kosten dafür bleiben unsichtbar, weil sie auf keinem konkreten Projekt gebucht werden. Doch sie summieren sich als leise Entwertung der Zeit deiner erfahrensten Kräfte.
Kennst du das Muster der Personendatenbank? Lies als Nächstes: Wenn dein bester Mitarbeiter morgen kündigt: Was bricht weg?
Wie sieht es aus, wenn Daten strukturiert sind?
Das Ziel ist einfacher zu erreichen, als die meisten Unternehmen erwarten:
Jede Datenkategorie hat eine primäre Quelle. Das Team weiß exakt, welches System verbindlich ist. Gibt es einen Widerspruch zwischen zwei Zahlen, weiß jeder sofort, welcher Version zu vertrauen ist.
Einmal erfasste Daten erscheinen überall dort, wo sie gebraucht werden. Kundendaten, die im CRM eingegeben werden, fließen automatisch in das Rechnungs-Tool, das Projektsystem und das Reporting-Dashboard. Niemand tippt sie ein zweites Mal ein. Niemand kopiert sie manuell.
Informationen zu finden hängt nicht davon ab, wen man fragen muss. Neue Mitarbeiter können Kundendaten, Projektzustände oder Finanzzahlen lokalisieren, ohne einen Kollegen anzurufen. Das System beantwortet die Frage, nicht der Mensch.
Berichte bilden die Realität ab – nicht den Stand von gestern. Das Dashboard des Geschäftsführers zeigt aktuelle Daten, nicht den Schnappschuss von der letzten manuellen Tabellenaktualisierung.
Das erfordert kein riesiges IT-Projekt. Es beginnt mit der Bestandsaufnahme, die du gerade abgeschlossen hast: Du erkennst, wo Daten doppelt vorkommen, legst fest, welche Quelle primär ist, und erstellst einen Plan zur Eliminierung der Kopien. Der erste Schritt ist fast immer Konsolidierung, nicht neue Technologie.
Warum das das Fundament für alles andere ist (inklusive KI)
Jede operative Verbesserung setzt voraus, dass Daten an der richtigen Stelle liegen. Du kannst keinen Ablauf automatisieren, wenn die dafür benötigten Daten im Posteingang von jemandem liegen. Du kannst kein Dashboard bauen, wenn die Zahlen aus drei widersprüchlichen Excel-Listen stammen. Und du kannst dein Team nicht auf ein System einschulen, wenn niemand den Daten dieses Systems vertraut.
Falls du über den Einsatz von KI-Tools nachdenkst: KI braucht Daten, um zu funktionieren. Wenn diese Daten über fünfzehn Plattformen mit widersprüchlichen Ständen verstreut sind, liefert dir die KI fünfzehn verschiedene Antworten – je nachdem, welche Version sie zuerst findet.
Der State-of-AI-Bericht 2025 von McKinsey bestätigt das empirisch: Von 25 untersuchten organisatorischen Faktoren hatte die Neugestaltung von Abläufen und Datenströmen den mit Abstand größten Einfluss darauf, ob Unternehmen einen messbaren EBIT-Effekt durch KI erzielen. Leistungsstarke Unternehmen strukturierten ihre Datenströme fast dreimal häufiger um, bevor sie KI-Tools einsetzten. Gartner prognostiziert, dass Unternehmen bis Ende 2026 rund 60 % aller KI-Projekte aufgeben werden, weil die nötige Datenbasis fehlt. Eine Single Source of Truth ist keine bloße Frage der Organisation. Sie ist die technische Voraussetzung für jedes KI-Tool, jede Automatisierung und jedes Dashboard, das du jemals einsetzen willst.
Für das vollständige Bild zu KI-Bereitschaft und Datenqualität: 95 % der KI-Projekte bringen null ROI. Warum das so ist und was du zuerst reparierst.

McKinsey's State of AI 2025 bestätigt das empirisch: Von 25 untersuchten organisatorischen Faktoren hatte die Neugestaltung von Abläufen und Datenströmen den mit Abstand größten Einfluss darauf, ob Unternehmen einen messbaren EBIT-Effekt durch KI erzielen. Leistungsstarke Unternehmen strukturierten ihre Datenströme fast dreimal häufiger um, bevor sie KI-Tools einsetzten.
Wo fängst du an?
Du musst nicht alles auf einmal reparieren. Starte mit der Datenkategorie, die täglich den größten Schmerz verursacht.
Schritt 1: Prüfe deine Bestandsaufnahme. Finde die Kategorie mit den meisten Duplikaten und der größten Unklarheit darüber, welche Version verbindlich ist.
Schritt 2: Lege fest, welche Quelle primär ist. Das ist eine Führungsentscheidung, keine technische. Wähle das System, das am vollständigsten, am meisten genutzt und am vertrauenswürdigsten ist. Erfüllt keines diese Kriterien, nimm dasjenige, das ihnen am nächsten kommt.
Schritt 3: Mustere die Kopien aus. Das ist der schwere Teil. Es bedeutet, dem Team zu sagen, dass die Excel-Liste, die sie seit drei Jahren nutzen, nicht mehr die Datenquelle ist. Es bedeutet auch, alle einzigartigen Daten aus den Kopien in die primäre Quelle zu migrieren, bevor du sie löschst.
Schritt 4: Schaffe eine eiserne Regel: Daten werden zuerst in der primären Quelle erfasst. Alles andere zieht die Daten entweder automatisch von dort oder wird gar nicht erst aktualisiert.
Eine Datenkategorie konsolidiert. Eine Reihe widersprüchlicher Versionen eliminiert. Das allein spart wöchentlich Stunden an Verwirrung und doppelter Dateneingabe – und gibt dir ein verlässliches Fundament, auf dem du aufbauen kannst.
Bereit, die Prozesse zu kartieren, die deine Daten bewegen? Lies als Nächstes: So kartierst du einen Geschäftsprozess. Auch wenn du es noch nie gemacht hast.
Möchtest du die Engpässe identifizieren, die deine verstreuten Daten verursachen? Lies als Nächstes: Fünf Arten von Engpässen, die dein Unternehmen ausbluten lassen. Und wie du sie erkennst.
Dein nächster Schritt
Verstreute Daten sind kein Technologieproblem. Es ist ein Sichtbarkeitsproblem. Wenn Informationen an zu vielen Orten liegen, sieht niemand mehr das große Ganze. Entscheidungen verlangsamen sich, Fehler vervielfachen sich und das Team verbringt seine Zeit damit, Daten zu verwalten, anstatt echte Arbeit zu erledigen.
Du hast jetzt die Übung zur Bestandsaufnahme und einen klaren Startpunkt. Du kannst heute Nachmittag kartieren, wo deine Daten liegen.
Daten zu konsolidieren, Tools zu verbinden und die Architektur für eine Single Source of Truth aufzubauen, erfordert Fachwissen und fokussierte Zeit. Zu entscheiden, welche Quelle primär ist, ist der einfache Teil. Daten zu migrieren, zu bereinigen, zu verknüpfen und das Team so zu schulen, dass es der neuen Struktur vertraut, erfordert monatelange, gezielte Arbeit.
Wenn du wissen willst, wo deine Daten tatsächlich liegen und was nötig ist, um eine Single Source of Truth für dein Unternehmen zu bauen: Wir starten mit einem strukturierten Daten-Audit über deine Tools, Systeme und Abläufe hinweg. Danach folgt ein klarer Architekturplan. Anschließend die Umsetzung in Sprints. Und wir bleiben auch nach dem Aufbau an deiner Seite.
Bereit zu sehen, wo deine Daten wirklich liegen? Buch dir ein kostenloses Data-Audit.
Egal, ob du das Thema selbst angehst oder an uns übergibst: Wir hoffen, dass dieser Leitfaden das unsichtbare Chaos sichtbar macht und dir einen klaren ersten Schritt gibt.
Häufig gestellte Fragen (FAQ)
Was sind Datensilos und warum sind sie ein Problem?
Datensilos entstehen, wenn dieselbe Information an mehreren, voneinander getrennten Orten mit unterschiedlichen Ständen liegt: Kundendaten im CRM und in einer Excel-Liste, Finanzzahlen in der Buchhaltung und in einem manuellen Bericht. Laut DATAVERSITY-Studie 2026 nennen 68 % der Unternehmen Datensilos als ihr größtes operatives Problem. Die Folge: unzuverlässige Entscheidungen, Zeitverschwendung beim Datenabgleich und ein Geschäftsführer, der kein klares Bild seines Unternehmens sieht, ohne Daten aus sechs Quellen zusammenzutragen.
Wie verschaffe ich mir einen Überblick darüber, wo die Daten meines Unternehmens liegen?
Richte den Blick auf alle Datenkategorien (Kunden, Projekte, Finanzen, Mitarbeiter, Lieferanten, Verträge, Termine). Notiere für jede Kategorie jeden Aufbewahrungsort: Software, Excel-Listen, E-Mail-Postfächer, Chat-Kanäle, Netzlaufwerke und die Köpfe der Mitarbeiter. Markiere die verbindliche Quelle und zähle die Kopien. Jede Kategorie mit drei oder mehr Orten bedeutet, dass jemand wöchentlich Zeit verschwendet, um Stände manuell synchron zu halten, und meist daran scheitert.
Benötige ich neue Software, um Datensilos aufzulösen?
In der Regel nicht. Die Lösung beginnt mit einer Führungsentscheidung: Welches bestehende System ist pro Kategorie die primäre Quelle? Anschließend werden Kopien ausgemustert, einzigartige Daten in die primäre Quelle migriert und dem Team mitgeteilt, dass die alte Excel-Liste nicht mehr gilt. Eine einzige konsolidierte Kategorie spart wöchentlich Stunden an Verwirrung und doppelter Dateneingabe. Die passende Technologie folgt erst nach dieser organisatorischen Entscheidung, niemals davor.
Warum entscheidet die Datenqualität über den Erfolg von KI?
Jedes KI-Tool, jede Automatisierung und jedes Dashboard setzt voraus, dass Daten sauber, strukturiert und zugänglich sind. Liegen Kundendaten an fünf Orten mit widersprüchlichen Ständen, übernimmt die KI diese Verwirrung und verstärkt sie. Gartner prognostiziert, dass Unternehmen bis Ende 2026 rund 60 % aller KI-Projekte aufgeben werden, weil die nötige Datenbasis fehlt. Eine Single Source of Truth pro Datenkategorie ist die technische Voraussetzung für jedes KI-Tool, das ein Unternehmen einsetzen möchte.